안녕하세요, 올리브영에서 매장·본사 업무 시스템을 개발하고 있는 임밥입니다. 오늘은 오래된 문자 발송 데몬을 걷어내면서, 발송량에 견주면 한참 과해 보이는 구조를 일부러 택했던 이야기를 해보려 합니다.
들어가며
저희 메시지 발송 시스템의 평소 발송량은 초당 1건에도 미치지 못합니다. 이는 저희 팀이 다루는 메시지(SMS/LMS) 서비스의 발송량을 최근 1년 치 이력으로 계산한 결과이며, 하루로 따져도 수천 건 규모입니다. 이 정도 부하라면 서버 한 대에 crontab으로 주기적인 배치를 하나 걸어 두는 정도로도 충분히 감당할 수 있습니다. 그런데 이 시스템을 새로 설계하며 도입한 구조는 변경 데이터 캡처(CDC), 메시지 큐(Kafka), 별도의 발송 처리 워커, 예외 상황별 트랜잭션 처리, 구간별 모니터링으로 이루어져 있습니다.
어떻게 보면 이 구조는 트래픽 대비 과합니다. 또한 이 시스템은 발송을 필요로 하는 수십 개 서비스가 통합 메시지 API를 직접 호출하는 구조로 옮겨 가면 사라질 예정입니다. 사라질 것을 알면서도 과한 구조를 택했습니다. 이 글의 오버엔지니어링은 그런 뜻입니다. 그렇다면 이렇게 사라질 구조에 왜 오버엔지니어링을 했을까요? 저희가 스스로에게 던진 질문은 세 가지였습니다.
(1) 전환의 위험이 이 복잡함보다 비싼가
(2) 전환하는 동안 조용히 실패하는 곳이 없는가
(3) 전환이 끝나면 사라지는가
걷어내야 했던 것: 레거시 데몬 프로세스
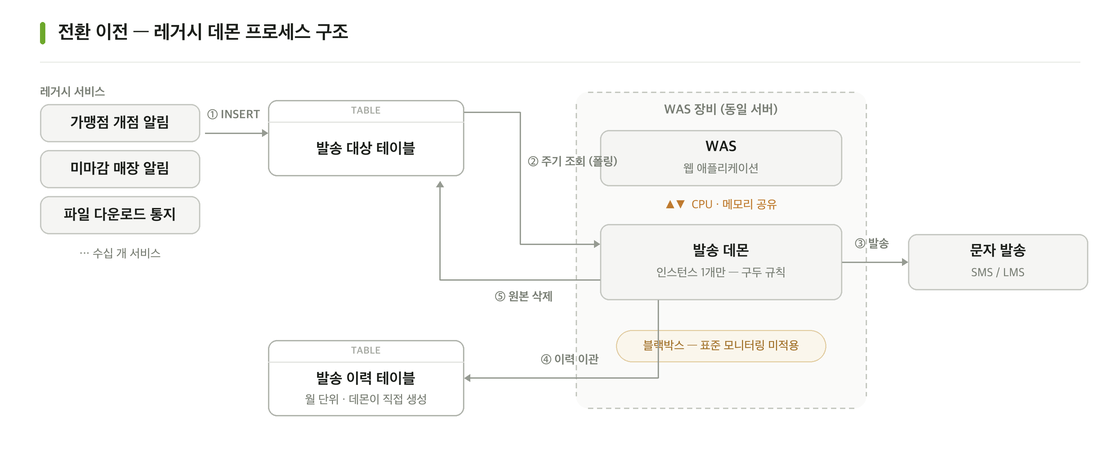
전환 이전에 SMS/LMS 발송은 오래된 데몬 프로세스가 담당했습니다. 각 서비스가 발송 대상 테이블에 보낼 메시지를 INSERT하면, 데몬 프로세스가 이를 주기적으로 조회해 발송하고, 발송 이력을 별도 이력 테이블로 옮긴 뒤 원본을 삭제하는 구조였습니다. 오랫동안 큰 문제 없이 운영되어 왔기 때문에 검증된 방식이었지만, 운영 관점에서는 다음과 같은 부채가 쌓여 있었습니다.
(1) 격리되지 않은 실행 환경: 웹 애플리케이션 서버(WAS)와 같은 장비에서 데몬으로 동작했습니다. 대량 발송이 몰리면 WAS와 CPU 및 메모리를 나눠 쓰게 되어 서비스 성능에 영향을 주었고, 장비를 재기동해야 할 때도 서로 격리되지 않았습니다.
(2) 들여다볼 수 없는 블랙박스: 별도 데몬이라 표준 모니터링 체계가 걸려 있지 않아, 장애가 나도 어느 단계에서 발생했는지 추적하기가 어려웠습니다.
(3) 표준에서 벗어난 운영: 월 단위로 나뉜 이력 테이블을 데몬이 직접 생성했고, 발송 계정도 수백 개로 흩어져 있었습니다.
(4) 사람에게만 묶여 있던 규칙: 인스턴스를 둘 이상 켜면 중복 발송이 날 수 있어 하나만 켜 둬야 한다는 규칙이 코드에도 설정에도 없이 담당자 간의 인수인계로만 전해졌습니다.
💡 참고: 이 발송 시스템은 가맹점 개점 알림, 미마감 매장 알림, 대용량 파일 다운로드 완료 통지 등 성격이 제각각인 수십 개의 서비스가 함께 사용합니다. 한 곳에서 장애가 나면 여러 서비스의 알림이 동시에 영향을 받습니다.
최종 목표 구조와 과도기 구조
전환의 최종 목표 구조는 발송 대상 테이블을 없애고, 각 서비스가 메시지 발송을 담당하는 API 서버인 통합 메시지 서버를 직접 호출하는 것입니다. 그렇다면 처음부터 이 단순한 구조로 가면 될 텐데, 왜 그 사이에 CDC와 Kafka를 끼워 넣었을까요?
단순한 구조로 곧장 갈 수 없었던 이유
발송 대상을 만들어 내는 쪽, 즉 레거시가 문제였습니다. 앞서 언급한 수십 개의 서비스는 하나같이 발송 대상 테이블에 직접 INSERT하거나 발송용 저장 프로시저를 호출하는 방식에 강하게 묶여 있었습니다. 발송을 유발하는 배치 작업만 해도 수십 개가 여기저기 흩어져 있었고, 일부 발신번호는 하드코딩되어 있기까지 했습니다.
이 많은 서비스를 한 번에 "API 직접 호출"로 바꾸는 전환은 현실적으로 불가능합니다. 하나라도 놓치면 그 서비스의 알림이 조용히 끊기고, 그 사실을 한참 뒤에야 알게 됩니다. 단순한 종착점은 정해져 있지만, 거기까지 안전하게 건너갈 다리가 필요했습니다.
다리를 놓는 다른 방법들
CDC와 Kafka가 처음부터 정답이었던 것은 아닙니다. 앞에서 적은 부채들을 모두 해결할 수 있는 방향을 다음과 같이 고민해 보았습니다.
(1) 기존 데몬의 폴링 주기만 줄이기: 가장 손이 적게 가는 방법입니다. 다만 주기를 줄일수록 아무것도 없는 테이블을 조회하는 횟수만 늘어나, 평소에는 데이터베이스 부하만 키웁니다. 무엇보다 데몬은 여전히 WAS와 같은 장비에 얹혀 대량 발송이 몰리면 서비스 응답에 영향을 주고, 표준 모니터링 바깥에 있어 장애가 나도 어느 단계에서 났는지 알 수 없습니다.
(2) 서버 한 대에 crontab으로 배치 걸기: 사실 발송량을 고려하면 이것으로 충분합니다. 또한 WAS와 분리된 장비에 별도 애플리케이션으로 올리면 격리가 생기고, 사내 표준 모니터링 체계에도 얹을 수 있습니다. 하지만 배치는 여전히 한 대만 띄워야 중복이 나지 않고, 늘리려면 락이나 분산 처리를 직접 만들어야 하고, 그 구현이 맞는지 다시 검증해야 합니다. 이 부분이 crontab을 접은 이유였습니다.
(3) 큐를 직접 간단히 구현하기: 테이블 하나를 큐처럼 쓰고, 여러 워커가 같은 건을 집지 않게 하는 배타적 점유와 처리 위치 기록, 재처리, 순간 폭증 시의 완충을 손으로 만드는 방식입니다. 가능은 합니다. 다만 이것들은 메시지 큐가 이미 제공하는 기능이고, 저희가 만들 것은 전환이 끝나면 걷어낼 구간에 들어갑니다. 사라질 코드의 양을 늘리면서 그 코드의 정확성까지 책임져야 합니다.
(4) CDC 없이 각 서비스가 직접 이벤트를 발행하기: 가장 깔끔해 보이지만, 수십 개 서비스와 저장 프로시저를 전부 고쳐야 하므로 그 자체가 빅뱅입니다. 그리고 모든 서비스를 수정할 수 있는 상황이라면 큐를 거칠 이유가 없습니다. 통합 메시지 API를 바로 호출하면 됩니다. 이 선택지는 과도기 구조의 대안이 될 수 없습니다. 최종 목표 구조 그 자체이고, 저희는 거기에 곧장 갈 수 없다고 판단했습니다.
저희가 선택한 과도기 구조
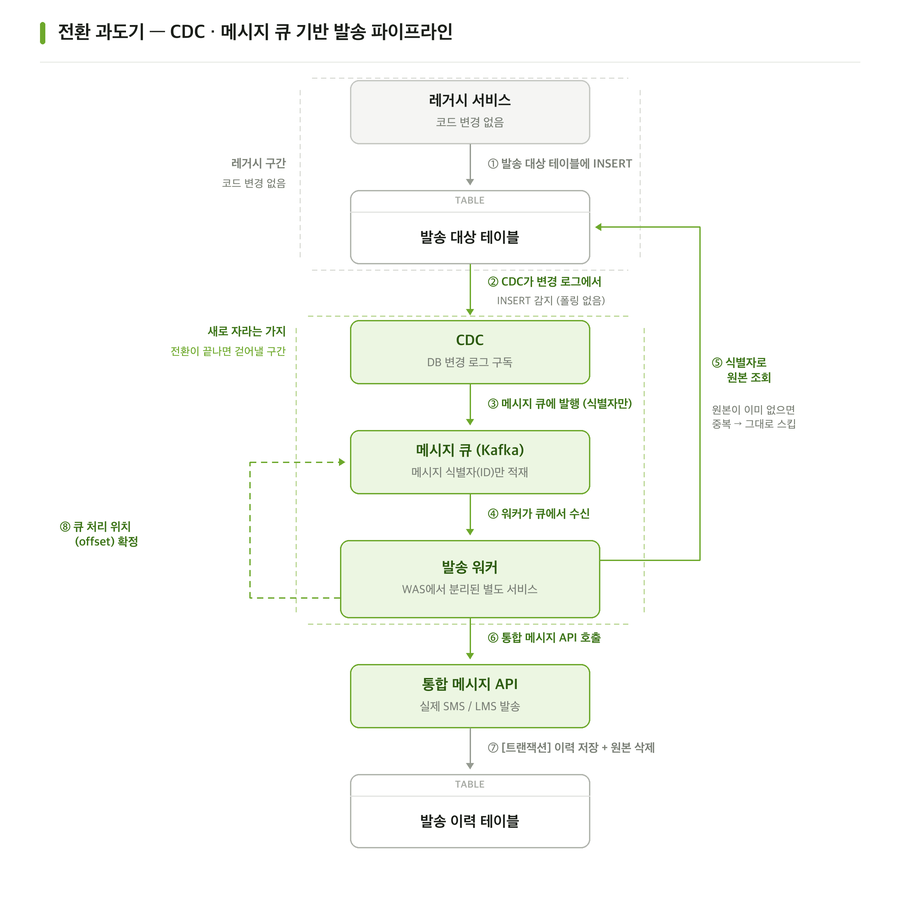
저희는 레거시의 발송 방식은 그대로 두고, 발송을 실제로 수행하는 뒷단만 교체했습니다. 레거시를 한 번에 갈아엎는 대신 그 가장자리에서 새 시스템을 조금씩 키우는 이 방식에는 이미 이름이 있습니다. Martin Fowler가 정리한 Strangler Fig 패턴입니다. Strangler Fig란 교살무화과나무라는 뜻으로, 식물에서 온 이름입니다. 이 식물은 다른 나무의 틈에서 싹을 틔워 그 나무를 타고 자라다가 결국 스스로 서고, 숙주 나무는 죽어 껍데기만 남습니다.
💡 참고: CDC(Change Data Capture, 변경 데이터 캡처)는 데이터베이스에 생긴 변경(
INSERT/UPDATE/DELETE)을 실시간으로 감지해 다른 시스템으로 흘려보내는 기술입니다. 테이블을 반복해서 조회(폴링)하지 않고, 데이터베이스가 남기는 변경 로그를 읽어 감지하기 때문에 원본에 주는 부하가 적습니다. 올리브영 테크블로그에도 관련 글이 많이 올라와 있으니 참고해 보세요.
레거시 서비스는 코드를 한 줄도 바꾸지 않습니다. 여전히 테이블에 INSERT할 뿐입니다. 바뀐 것은 그 INSERT를 누가, 어떻게 발송하느냐뿐입니다. 수십 개의 서비스를 건드리지 않고 발송 방식을 통째로 교체할 수 있다는 것, 이것이 이 구조가 존재하는 가장 큰 이유입니다. 앞에서 적은 부채 네 가지도 여기서 정리됩니다.
(1) 발송 워커는 WAS와 분리된 별도 애플리케이션이라 대량 발송이 서비스 응답에 영향을 주지 않고, 발송 쪽만 따로 늘리거나 재기동할 수 있습니다.
(2) 사내 표준 모니터링 체계에 그대로 얹히면서 CDC 감지·큐 적재·워커 처리·API 응답을 구간별로 나눠 볼 수 있게 됐습니다.
(3) 이력 테이블 생성과 발송 계정 관리는 통합 메시지 서버 쪽으로 넘어가 한곳에 모였습니다.
(4) "한 대만 켜 둬야 한다"는 구두 규칙은 컨슈머 그룹이 대신합니다.
큐에는 메시지 전체 내용이 아니라 메시지 식별자(ID)만 싣고, 워커는 그 식별자로 데이터베이스에서 원본을 다시 조회합니다. 큐는 "무엇을 처리해야 하는지"만 알리고, 데이터의 원본은 항상 데이터베이스 한 곳에 둡니다. 큐를 거치는 동안 데이터가 낡거나 어긋날 여지를 없애기 위한 선택입니다.
💡 참고: 이렇게 큐에는 식별자만 싣고 실제 데이터는 신뢰할 수 있는 저장소에서 다시 읽어오는 방식을 클레임 체크(Claim Check) 패턴이라고 부릅니다. 메시지 크기를 줄이고, 데이터 정합성을 지키는 효과가 있습니다.
레거시가 만들어 내는 변경을 이렇게 가로채 새 컴포넌트로 흘려보내는 것도 Patterns of Legacy Displacement 시리즈에 Event Interception이라는 이름으로 정리되어 있습니다. 저희에게 그 지점은 발송 대상 테이블의 INSERT였습니다. 수십 개 서비스가 공통으로 지나가는 유일한 길목이니까요. 즉 CDC와 Kafka는 Strangler Fig를 이 환경에서 실행하기 위한 가로채기 장치입니다. 그리고 이런 과도기 구조를 일부러 만드는 일에 대해, Martin Fowler는 앞서 소개한 Strangler Fig 글에서 저희가 이번 전환에서 하려던 말을 거의 그대로 적어 두었습니다.
"When doing this, people often balk at the necessity of building transitional architecture to allow the new and legacy system to coexist, code that will go away once the modernization is complete. While this may appear to be a waste, the reduced risk and earlier value from the gradual approach outweigh its costs."
(이렇게 전환할 때 사람들은 신규 시스템과 레거시가 공존하도록 과도기 아키텍처를 만들어야 한다는 사실에 종종 거부감을 느낍니다. 현대화가 끝나면 사라질 코드니까요. 낭비처럼 보이지만, 점진적 접근이 주는 위험 감소와 조기 가치 실현이 그 비용을 넘어섭니다.)
제가 이번 포스트 서론에 적은 정의가 여기서 이어집니다. 끝나면 사라질 코드를 일부러 만든다는 것은 이름과 근거가 이미 있는 선택지였습니다. 저희가 새로 발견한 통찰은 아닙니다. 그리고 이 선택에는 '현대화가 끝나면 걷어낸다'는 조건이 원래부터 따라붙어 있습니다.
되돌릴 수 없는 발송을 다루는 워커 설계
"통합 메시지 API를 호출한다"는 한 줄 뒤에는 생각보다 성가신 문제들이 숨어 있습니다. 발송은 되돌릴 수 없는 작업이기 때문입니다. 데이터베이스 트랜잭션은 롤백할 수 있지만, 이미 나간 문자는 되돌릴 수 없습니다. 워커 설계의 대부분은 이 비대칭을 다루는 데 들어갔습니다.
순서 문제
API 호출과 이력 저장 중 무엇을 먼저 할지부터 결정해야 합니다. 이력을 먼저 남기고 발송하면 '보냈다고 기록됐는데 안 나간 경우'가 생기고, 발송을 먼저 하고 이력을 남기면 '나갔는데 기록이 없는 경우'가 생깁니다. 저희는 후자를 택했습니다. 알림이 조용히 누락되는 것보다, 나간 기록이 잠깐 비는 쪽이 복구 가능한 사고이기 때문입니다.
중복 발송 문제
메시지 큐는 기본적으로 "최소 한 번(at-least-once)" 전달을 보장합니다. 워커가 발송을 마치고 처리 위치(offset)를 확정하기 직전에 죽으면, 같은 메시지를 다시 받게 됩니다. 그래서 발송 전에 원본이 아직 발송 대상 테이블에 남아 있는지를 확인하고, 발송 후 이력 저장과 원본 삭제를 하나의 트랜잭션으로 묶었습니다. 재수신되더라도 원본이 이미 사라져 있으면 그대로 넘어갑니다.
여러 대를 띄웠을 때의 중복은 컨슈머 그룹이 막아 줍니다. 같은 그룹에 속한 워커들에게 파티션이 배타적으로 나뉘어 할당되므로, 한 메시지를 두 워커가 동시에 집어 갈 일이 없습니다. 레거시 데몬 시절 인수인계로만 전해지던 "인스턴스를 하나만 켜 둬야 한다"는 규칙이, 이제는 구조로 보장됩니다. 직접 만든 배치나 큐를 골랐다면 이 부분을 손으로 구현하고 그 구현을 다시 검증해야 했을 것입니다.
실패 처리 문제
외부 API 실패라고 다 같지는 않습니다. 타임아웃이나 일시적 오류는 다시 보내면 풀리지만, 잘못된 수신번호나 규격에 맞지 않는 본문처럼 몇 번을 보내도 똑같이 실패하는 것들이 있습니다. 후자를 계속 재시도하면 그 메시지 하나가 큐 앞을 막아 뒤에 쌓인 정상 메시지까지 함께 지연됩니다.
그래서 큐 단위 재시도는 두지 않기로 했습니다. 실패한 메시지도 처리 위치는 그대로 확정하고, 발송 결과를 실패로 기록한 뒤 넘깁니다. 재시도는 외부 API를 호출하는 지점에만, 네트워크 오류와 서버 오류(5xx)에 한해 약 3초 뒤 한 번으로 좁혔습니다. 잘못된 요청(4xx)이라면 다시 보내도 결과가 같으니 그대로 실패로 확정합니다.
이 선택에는 대가가 있습니다. 큐가 보관해 주는 재처리 기회를 스스로 포기한 셈입니다. 발송 실패는 이력에 결과로 남지만, 원본을 조회하는 단계에서 데이터베이스 연결이 불안정한 경우처럼 이력조차 남기지 못하는 실패는 로그로만 남습니다. 그럼에도 이렇게 둔 이유는 앞서 말한 비대칭입니다. 재시도는 언제나 중복 발송 쪽으로 위험을 옮기고, 한 건을 살리려고 큐 전체를 세우는 비용이 지금 발송량에서는 더 큽니다. 실패한 메시지를 골라 다시 흘려보내는 경로는 남은 과제로 두었습니다. 여기까지가 큐 뒤에서 벌어지는 일입니다. 발송량은 여전히 초당 1건이 안 됩니다.
기능 플래그를 끈 채 먼저 배포하는 전략
전환의 마지막 조각은 배포 전략이었습니다. 발송 기능을 켠 채로 한 번에 열지 않았습니다. 워커를 배포하되, 설정 테이블(공통 코드)로 관리하는 기능 플래그(feature flag)를 꺼 둔 상태로 먼저 배포했습니다. 이 상태에서 워커는 큐 메시지를 정상적으로 수신하지만, 실제 발송은 하지 않습니다.
그 사이 레거시 데몬이 맡던 기존 발송 경로가 정상적으로 동작하는지, 시간대별 트래픽 패턴이 평소와 같은지를 모니터링으로 검증하고, 확인이 끝난 뒤에야 플래그를 켜 서비스를 열었습니다.
전환할 때는 플래그를 먼저 켜고 레거시 데몬을 나중에 내렸습니다. 이 순서라면 잠시 두 경로가 함께 발송하는 구간이 생기므로, 전환은 발송량이 거의 없는 시간대를 골라 진행했습니다. 실제 발송을 맡는 외부 메시지 API도 짧은 시간 안에 같은 수신자에게 같은 내용으로 들어온 요청은 한 번만 보내 주었기 때문에, 중복 발송은 일어나지 않았습니다.
배포와 오픈을 떼어 놓은 덕분에, 새 구조를 실제 운영 트래픽 위에 올려 두면서도 언제든 되돌릴 수 있는 검증 구간을 확보할 수 있었습니다.
초당 1건 미만에도 큐와 모니터링이 필요했던 이유
다시 처음의 "초당 1건도 안 된다"는 이야기로 돌아가 보겠습니다. 평균은 분명 작습니다. 하지만 발송은 한꺼번에 몰리곤 합니다. 실제로 특정 10분 사이에 1만 건이 넘게 쌓인 적이 있습니다. 평균의 수백 배가 순간적으로 몰린 것입니다. 큐는 이런 순간 폭증을 완충해, 뒷단이 감당할 수 있는 속도로 흘려보내는 역할을 합니다. crontab 배치였다면 이 순간에 한 주기 안에 처리하지 못한 물량이 그대로 다음 주기로 밀리고, 밀린 만큼 알림이 늦게 도착했을 것입니다.
규모는 측정으로 정했습니다. 워커 한 대는 메시지를 한 건씩 차례로 처리합니다. 최근 15일 운영 기준으로 한 건을 처리하는 데 외부 메시지 API 응답까지 포함해 평균 67밀리초, 발송이 몰리는 시간대에도 120밀리초 안팎이 걸렸습니다. 이 시간의 대부분은 외부 API 응답을 기다리는 시간이고, 워커 자체 로직은 그때도 20밀리초 안팎입니다. 워커 한 대로 초당 10건 내외를 처리할 수 있었습니다. 평소 발송량의 열 배가 넘는 처리량이고, 이를 넘어서는 순간 폭증은 앞서 말한 큐가 받아 둡니다.
규모만 따진 것은 아닙니다. 전환기에 가장 무서운 것은 장애가 났는지조차 모르는 상태입니다. 격리와 관측성은 그래서 필요했습니다. 앞에서 부채 (1)과 (2)로 적은 것이 정확히 이 두 가지이고, 폴링 주기만 줄이는 방법으로는 이 둘을 해결하지 못했습니다. 구간별 계측은 평소에는 아무 의미가 없다가, 문제가 생긴 순간에 "어디서 막혔는지"를 즉시 답해 줍니다. 블랙박스였던 예전 데몬과 가장 크게 갈리는 지점입니다.
투자인 복잡함과 부채인 복잡함
복잡함이라고 다 같은 복잡함은 아닙니다. 실제 코드에는 제값을 하는 복잡함과, 형태만 남은 복잡함이 함께 있습니다. 이 둘을 구분하는 것이 오버엔지니어링을 다루는 실전 감각이라고 생각합니다.
제값을 하는 쪽부터 보겠습니다. SMS와 LMS는 조회할 테이블도, API 요청 규격도, 이력을 남길 테이블도 다릅니다. 이 차이를 공통 인터페이스 뒤로 숨기고, 실제 처리를 담당하는 구현체들을 메시지 종류별로 미리 등록해 두었습니다. 아래는 실제 코드를 단순화한 예시입니다.
// 메시지 종류별 발송 전략 (단순화한 예시)
interface MessageSender {
  val type: MessageType
  fun send(messageId: Long)
}

// 종류 -> 전략 레지스트리: 주입된 구현체들을 타입으로 색인
private val senders: Map<MessageType, MessageSender> = injectedSenders.associateBy { it.type }
덕분에 발송을 조율하는 중심 로직에는 종류별 if / when 분기가 하나도 없습니다. 종류가 늘어나도 조율 로직은 그대로 두고 구현체만 더하면 됩니다. 두 종류의 차이를 각 구현체 안에 가둬 두려는 선택이었습니다.
형태만 남은 쪽도 있습니다. 예를 들어 설정을 메시지 종류별로 각각 분리해 두었지만, 실제로는 두 설정이 동일한 값을 바라보는 경우가 있었습니다. 겉보기에는 종류마다 독립적으로 설정할 수 있을 것 같지만, 실제로는 유지보수 대상만 둘로 늘렸을 뿐 얻는 것이 없었습니다. "분리된 것처럼 보이는 중복"입니다.
오버엔지니어링에도 투자와 부채가 있습니다. 예상되는 변화에 대비한 추상화는 투자이고, 지금도 앞으로도 제값을 하지 못하는, 형태만 남은 복잡함은 부채입니다. 복잡함을 더할 때마다 "이건 어느 쪽인가"를 되묻는 습관이 필요합니다.
걷어낼 시점을 정하는 기준
과도기 아키텍처가 제값을 다하려면 마지막에 미련 없이 사라져야 합니다. 하지만 현실에서는 이런 구조가 그대로 눌러앉는 일이 흔합니다. 당장 급한 일이 아니고, 잘 운영되고 있으며, 굳이 시간을 들여 걷어냈을 때 무엇이 좋아지는지 설득하기 어렵기 때문입니다. 그러다 보면 레거시 하나를 없애려다 시스템 두 개를 동시에 떠안게 됩니다.
그래서 저희는 걷어낼 시점을 기간 대신 건수로 정했습니다. '발송 대상 테이블에 INSERT되는 건수가 0건'이 되는 시점입니다. 이때부터는 더 이상 이 시스템을 사용하지 않는 것으로 볼 수 있습니다. 기간을 정해 두지 않은 것은 월말이나 분기마다 한 번씩 도는 배치도 이 테이블에 INSERT하고, 이를 전환하는 일정이 스쿼드마다 달라 저희가 미리 가늠할 수 없었기 때문입니다.
마치며
처음에 던진 세 질문으로 돌아가 보겠습니다.
(1) 전환의 위험이 이 복잡함보다 비싼가: 수십 개 서비스를 유실 없이 옮겨야 했고, 하나라도 놓치면 그 알림이 조용히 끊깁니다. 빅뱅의 위험이 파이프라인의 복잡함보다 훨씬 비쌌습니다.
(2) 전환하는 동안 조용히 실패하는 곳이 없는가: 발송은 되돌릴 수 없어서, 순서와 중복과 실패를 다루는 데 워커 설계의 대부분이 들어갔습니다. 10분 사이에 1만 건이 몰려도 큐가 완충합니다. 기능을 끈 채 먼저 배포해 언제든 되돌릴 수 있는 상태에서 검증했고, 문제가 생기면 구간별로 나눠 봐서 어디서 막혔는지 답할 수 있습니다.
(3) 전환이 끝나면 사라지는가: 발송 대상 테이블로 들어오는 INSERT가 0건이 되는 순간이 걷어낼 시점입니다.
세 질문이 모두 전환을 향하고 있다는 점을 다시 짚고 싶습니다. 지금까지 설명한 CDC도, 큐도, 워커도, 구간별 모니터링도 전환이 끝나면 남지 않습니다. 각 서비스가 통합 메시지 API를 직접 호출하기 시작하면 이 모듈은 통째로 사라집니다. 앞서 인용한 문장 그대로, "현대화가 끝나면 사라질 코드"입니다.
그래서 이 글 제목의 오버엔지니어링은 "과하게 잘 만들었다"는 뜻이 아니라, 사라질 것을 알면서도 그만큼 공을 들였다는 뜻입니다. 그 값이 정당하려면 세 질문에 모두 답할 수 있어야 하고, 하나라도 답하지 못한다면 그건 그냥 과한 설계입니다.
코드 안을 들여다보는 잣대는 따로 필요합니다. 앞서 이야기한 투자와 부채의 구분이 그것이고, 저희 코드에도 아직 부채 쪽에 남아 있는 것들이 있습니다.
"단순함이 최선"이라는 말은 여전히 옳습니다. 다만 그 단순함이 어디의 단순함인지는 따져 볼 만합니다. 지금 코드의 단순함을 위해 전환의 위험을 떠안을 것인지, 전환의 안전을 위해 한동안의 복잡함을 감수할 것인지, 저희는 후자를 골랐습니다. 그리고 그 복잡함에는 유효기간을 붙여 두었습니다.
비슷한 전환을 앞두고 계신 분께 이 세 질문이 조금이나마 도움이 되었으면 좋겠습니다. 긴 글 읽어주셔서 감사합니다.
참고 자료
- Martin Fowler, StranglerFigApplication
- Ian Cartwright, Rob Horn, James Lewis, Event Interception (Patterns of Legacy Displacement)
- Gregor Hohpe, Bobby Woolf, Claim Check (Enterprise Integration Patterns)