안녕하세요! 😆
'ItemLM: 상품 정보 기반의 임베딩 생성기', 'T4 GPU 1장으로 일궈낸 올리브영의 Gemma 3 기반 sLLM 구축기'에 이어 세 번째 글로 돌아왔습니다. 올리브영에서 머신러닝으로 다양한 문제를 풀고 있는 🪄 데이터 사이언티스트 안일호입니다.
지난 글에서는 Tesla T4 GPU 1장이라는 제한된 환경에서 Gemma 3 기반 sLLM을 SFT(Supervised Fine-Tuning)해 리뷰 테마 추천에 적용한 첫 경험을 공유했습니다.
이번 글은 그 다음 프로젝트 이야기입니다. 올해 상반기에 새롭게 오픈한 추천 지면 AI Pick의 카드 생성 모델을 만들고 고도화하는 과정에서, SFT만으로는 넘을 수 없는 품질의 벽을 만났습니다. 그 해답을 post-training의 다음 단계인 정렬 학습(Alignment Learning)에서 찾았습니다.
"측정할 수 없으면 개선할 수 없다"는 문제의식에서 출발해, 자연스러움과 문맥적합을 수치화하는 평가 방법을 만들고, 이를 선호 학습(DPO, Direct Preference Optimization)과 강화학습(GRPO, Group Relative Policy Optimization)으로 연결한 과정을 지금부터 공유하겠습니다. 🍁
1. 올리브영의 추천 지면, AI Pick
먼저 이번 글에서 다루는 지면을 간단히 소개합니다. AI Pick은 상품 상세 정보를 바탕으로 추천 카드를 LLM으로 자동 생성해 보여주는 지면입니다. 아래 화면처럼 고객에게 노출되는 카드 한 장은 기본적으로 세 개의 문구 필드로 구성됩니다.
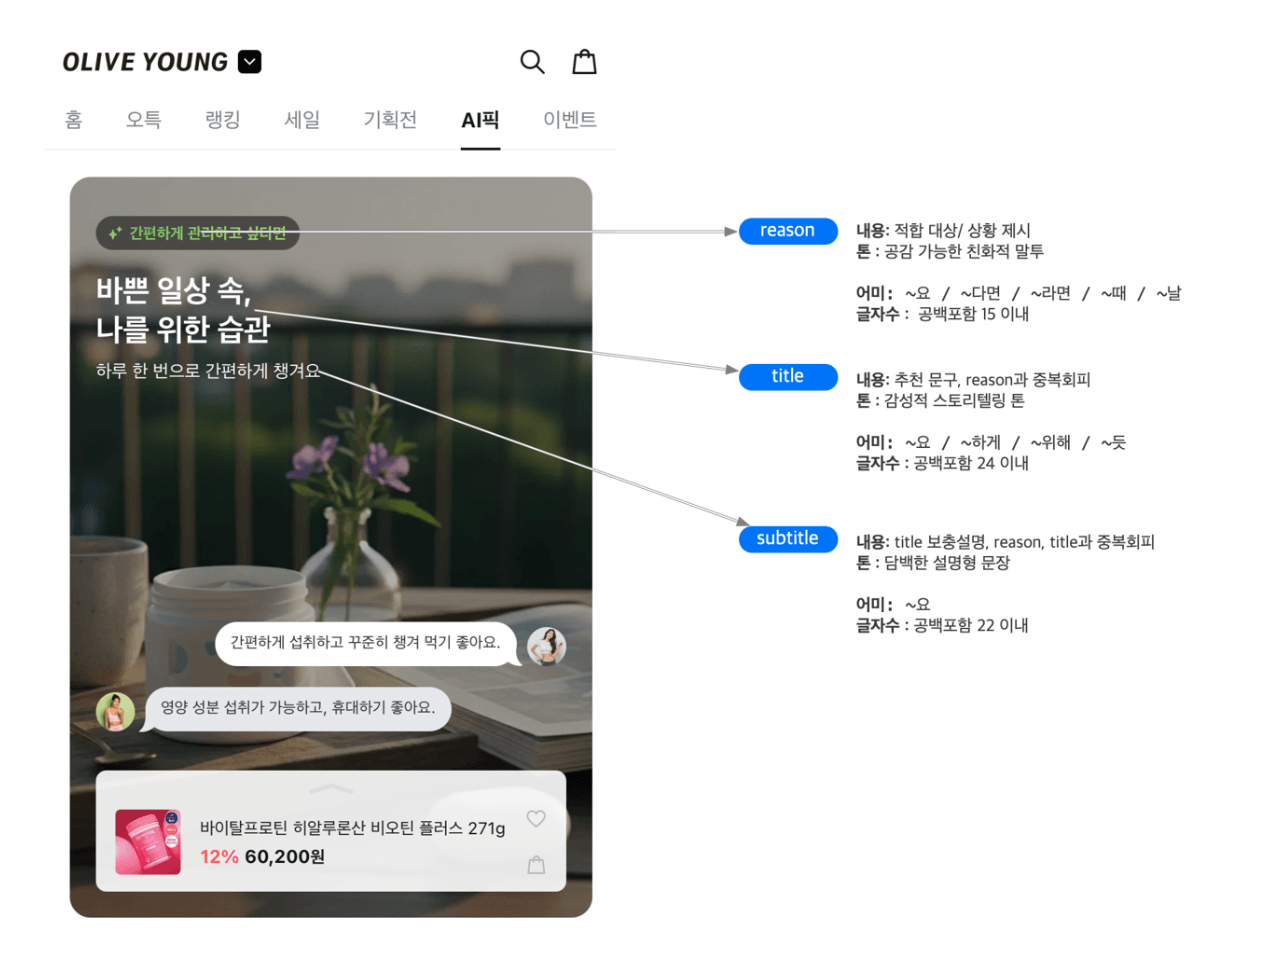
여기에 공통 규칙이 더해집니다. 출력은 반드시 정해진 JSON 배열 형태여야 하고, 브랜드명·상품명 언급 금지, 원문에 없는 효능·성분 추가 금지, 과장·의학적 보장 표현 금지, 세 필드 간 단어 중복 회피까지 지켜야 합니다. UI에 그대로 노출되는 텍스트라서, 하나라도 어기면 그 카드는 쓸 수 없습니다.
생성 파이프라인은 다음과 같이 흘러갑니다. 상품 상세페이지의 설명 이미지를 OCR로 텍스트화하고, 특징 추출 모델이 이를 세 개 섹션(상품 특징 / 사용·설치 팁 / 적합 대상·상황)으로 구조화합니다. 이 구조화된 상품 특징을 입력으로 카드 생성 모델이 추천 문구를 만들고, 이미지 생성을 거쳐 최종 추천 카드가 완성됩니다. 그리고 카드 생성 모델에는 목적이 다른 두 가지가 있습니다.
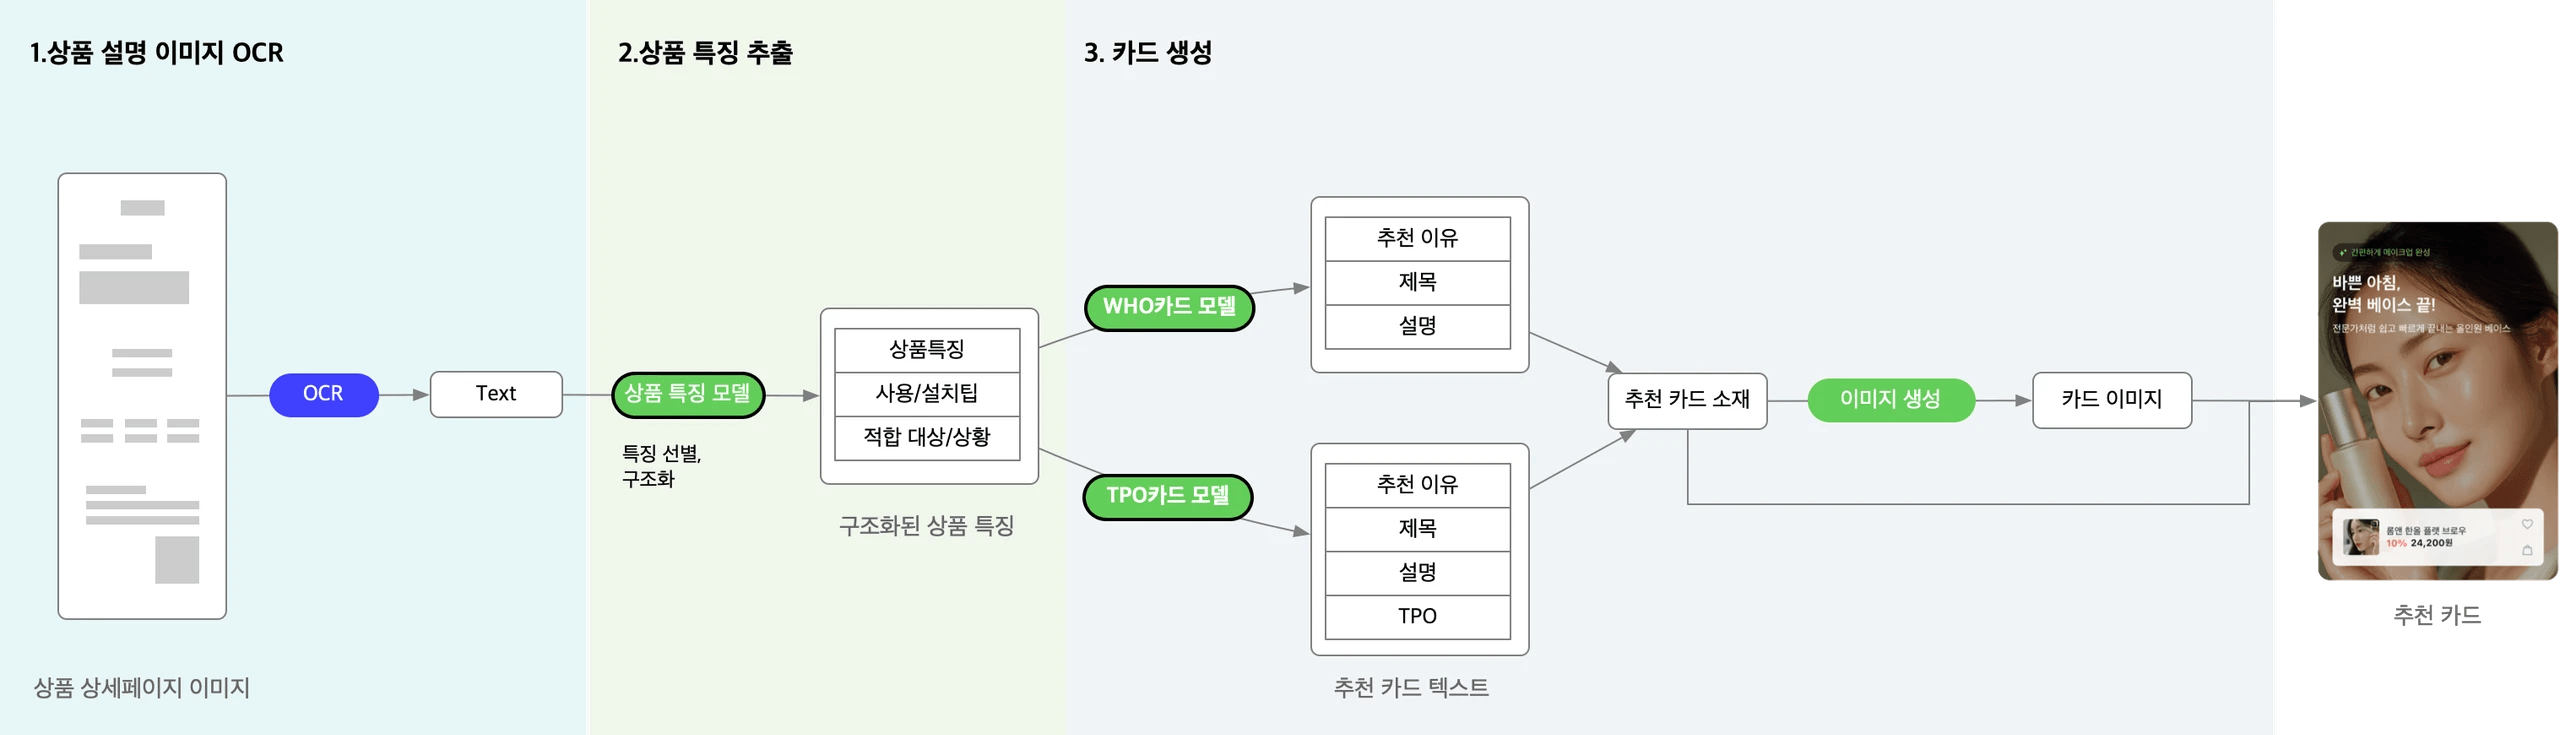
A: WHO 카드 (개인화)
- 이름 그대로 "이 상품을 누구에게(who), 왜 추천하는가"를 테마로,
reason/title/subtitle세 문구를 생성합니다.
B: TPO 카드 (시의성)
- TPO(Time·Place·Occasion)는 "언제, 어디서, 어떤 상황에 맞는가"를 뜻하는 리테일 용어입니다.
- AI Pick에서는 이를 계절(season)·시간(time)·장소(place) 세 슬롯으로 구체화해, 문구에 더해 함께 생성합니다.
season은 봄/여름/가을/겨울/전체,time은 새벽/아침/점심/저녁/밤/전체처럼 허용된 범주 안의 값만 써야 하고, 세 슬롯이 모두 '전체'이면 카드가 폐기되는 등 제약이 훨씬 촘촘합니다.
이렇게 생성된 카드는 별도의 추천 모델을 거쳐 지면에 노출됩니다. WHO 카드는 reason(추천 이유)을 근거로 사용자별 개인화 추천에, TPO 카드는 계절·시간·장소 조건을 기준으로 시의성에 맞는 추천에 사용됩니다. 다만 이 추천 단계는 이 글의 범위를 벗어나므로, 여기서는 카드를 '생성'하는 모델에 집중합니다.
모델은 Gemma3-4B-it 기반이며, 과제별 데이터로 SFT를 마친 모델이 이 글의 출발점입니다.
2. SFT만으로는 부족했던 이유
형식과 자연스러움을 '동시에' 만족시키는 문제
좋은 추천 카드의 조건을 분해하면 세 가지입니다. 세 조건을 동시에 만족시키는 것이 이 과제의 핵심 난관이었습니다. 특히 까다로운 지점은 자연스러움과 글자 수 제약을 동시에 지키는 것입니다. 공백 포함 15~24자 안에서 정해진 어미와 톤까지 맞추며 자연스러운 문장을 만들어야 하는데, 글자 수에 맞추려 하면 문장이 어색해지고 자연스럽게 쓰면 길이가 넘칩니다. 프롬프트에 제약 조건을 아무리 눌러 담아도 프론티어급 상용 모델조차 이를 안정적으로 통과하지 못했습니다. 실제로 프로젝트 초기 검증에서 제약사항을 모두 담은 프롬프트로 상용 대형 모델에 생성을 맡겼을 때, 검증 통과율은 WHO 55.4%, TPO 43.0%에 그쳤습니다. 같은 검증 기준에서 SFT를 마친 4B 모델은 각각 81.1%, 78.5%를 통과했습니다.
- 형식 준수: JSON 구조, 필드별 글자 수, 어미, 슬롯 범주를 지켜 실제 UI에 배치될 수 있는가
- 자연스러움: 문구가 한국어로 자연스럽고
reason → title → subtitle로 매끄럽게 이어지는가 - 문맥적합: 입력으로 주어진 상품 특징·사용 상황에 맞는가 (원문에 없는 내용을 지어내지 않는가)
평가 설정: 위 수치는 프로젝트 초기에 쓰던 검증 기준(형식과 어미를 정규식으로 검사하고 LLM 검증을 더한 방식)으로 측정한 통과율이라, 사실상 형식을 중심으로 평가한 결과입니다. 뒤에서 소개할 정렬 실험의 '형식 및 품질(자연스러움 및 문맥적합) 통과율'과는 평가 기준과 데이터셋이 다릅니다.
이 격차 때문에 리뷰 테마 프로젝트에서 저희는 상용 API 대신 자체 sLLM + SFT를 선택했고, AI Pick도 같은 전제에서 출발했습니다. 그런데 SFT를 마치고 나니, 이번에는 성격이 다른 문제가 드러났습니다.
SFT가 놓친 두 가지 불량
SFT를 마친 모델의 출력에서 실제로 마주친 불량은 두 종류였습니다.
- 여전히 남는 형식 위반: 글자 수를 두세 자 넘긴 문장, 어미 규칙을 어긴 문장이 계속 나왔습니다. 표 1의 통과율을 뒤집어 보면, 다섯 장 중 한 장꼴로 여전히 검증에서 탈락했습니다.
- 그럴듯하지만 상품과 안 맞는 문구: 예를 들어 '뷰러 리필 고무' 상품에 다음과 같은 카드를 생성하곤 했습니다. 문장 하나하나는 자연스럽지만, 뷰러 고무에 "다양한 색상으로 연출"은 명백히 어긋난 문구입니다. 자연스러움은 통과했지만 문맥적합에 실패한 출력입니다.
reason: 매일 다른 느낌을 원한다면
title: 하루의 시작과 마무리를 특별하게
subtitle: 다양한 색상으로 연출해 보세요
'좋은 카드'를 판정할 평가 기준의 부재
이런 출력을 걸러내고 개선하려면 평가 기준이 필요합니다. 형식은 규칙으로 검증할 수 있지만, 자연스러움과 문맥적합은 측정할 방법 자체가 없었습니다. 그리고 측정할 수 없으면 판단도, 개선도 할 수 없습니다. 그래서 AI Pick에서는 품질을 수치화하는 평가 지표를 먼저 만들고, 이를 학습 신호로 삼아 선호 최적화까지 적용했습니다. 무엇이 좋고 나쁜지를 사후 필터가 아니라 학습 신호로 모델에 직접 되돌려주는 방식입니다.
A: LLM-as-a-judge의 한계
- Gemini Pro급 대형 모델을 판정자로 세워도 화면에 그대로 노출할 품질을 가려내기에는 불완전
- 자연스러움·문맥적합·형식을 모두 따져야 하는 복잡한 판정
- 평가 지침의 표현이나 응답 순서에 따라 결과가 미세하게 흔들림 (Zheng et al., 2023)
B: 사람 평가의 한계
- "자연스럽다"는 말 안에는 명시하기 어려운 수많은 규칙이 내재
- 여러 사람이 같은 결과물을 평가해도 일관된 컨센서스가 나오지 않음
- 평가 모델을 학습시키려 해도 레이블 기준부터 세울 수 없음
3. 품질을 수치화하기: 형식 검증기와 두 개의 NLL 지표
형식은 검증기로, 품질은 프록시로
성질이 다른 평가 문제를 서로 다른 도구로 해결했습니다.
A: 형식
정답이 명확하므로 규칙 기반 검증기(validator)로 판정합니다. 필드별 최대 길이, 허용 어미, TPO 슬롯의 허용 범주를 정규식·스키마로 검사해 통과/실패를 결정적으로 가립니다. 형식에는 점수를 매기지 않고, 통과하지 못하면 그 자리에서 폐기하는 강한 제약(hard gate)으로 다룹니다.
B: 자연스러움과 문맥적합
언어모델의 학습 원리에서 착안했습니다. 언어모델의 사전 학습(pre-training)은 "다음 토큰이 얼마나 자연스럽게 이어지는가"의 확률을 학습하는 과정입니다. 이미 대량의 한국어를 학습한 언어모델이 계산하는 확률값이라면, 자연스러움의 프록시(proxy)로 쓸 수 있겠다고 판단했습니다. 저희는 생성 모델과 독립된 외부 평가 모델(external evaluator)로 고정된 공개 한국어 언어모델(Polyglot-Ko-1.3B)을 두고, 후보 출력 하나에 두 가지 방식으로 NLL(Negative Log-Likelihood)을 계산했습니다. 각각 자연스러움을 재는 nll_nat(natural)과 문맥적합을 재는 nll_ctx(context)로, 둘 다 손실값이라 낮을수록 좋은 지표입니다.
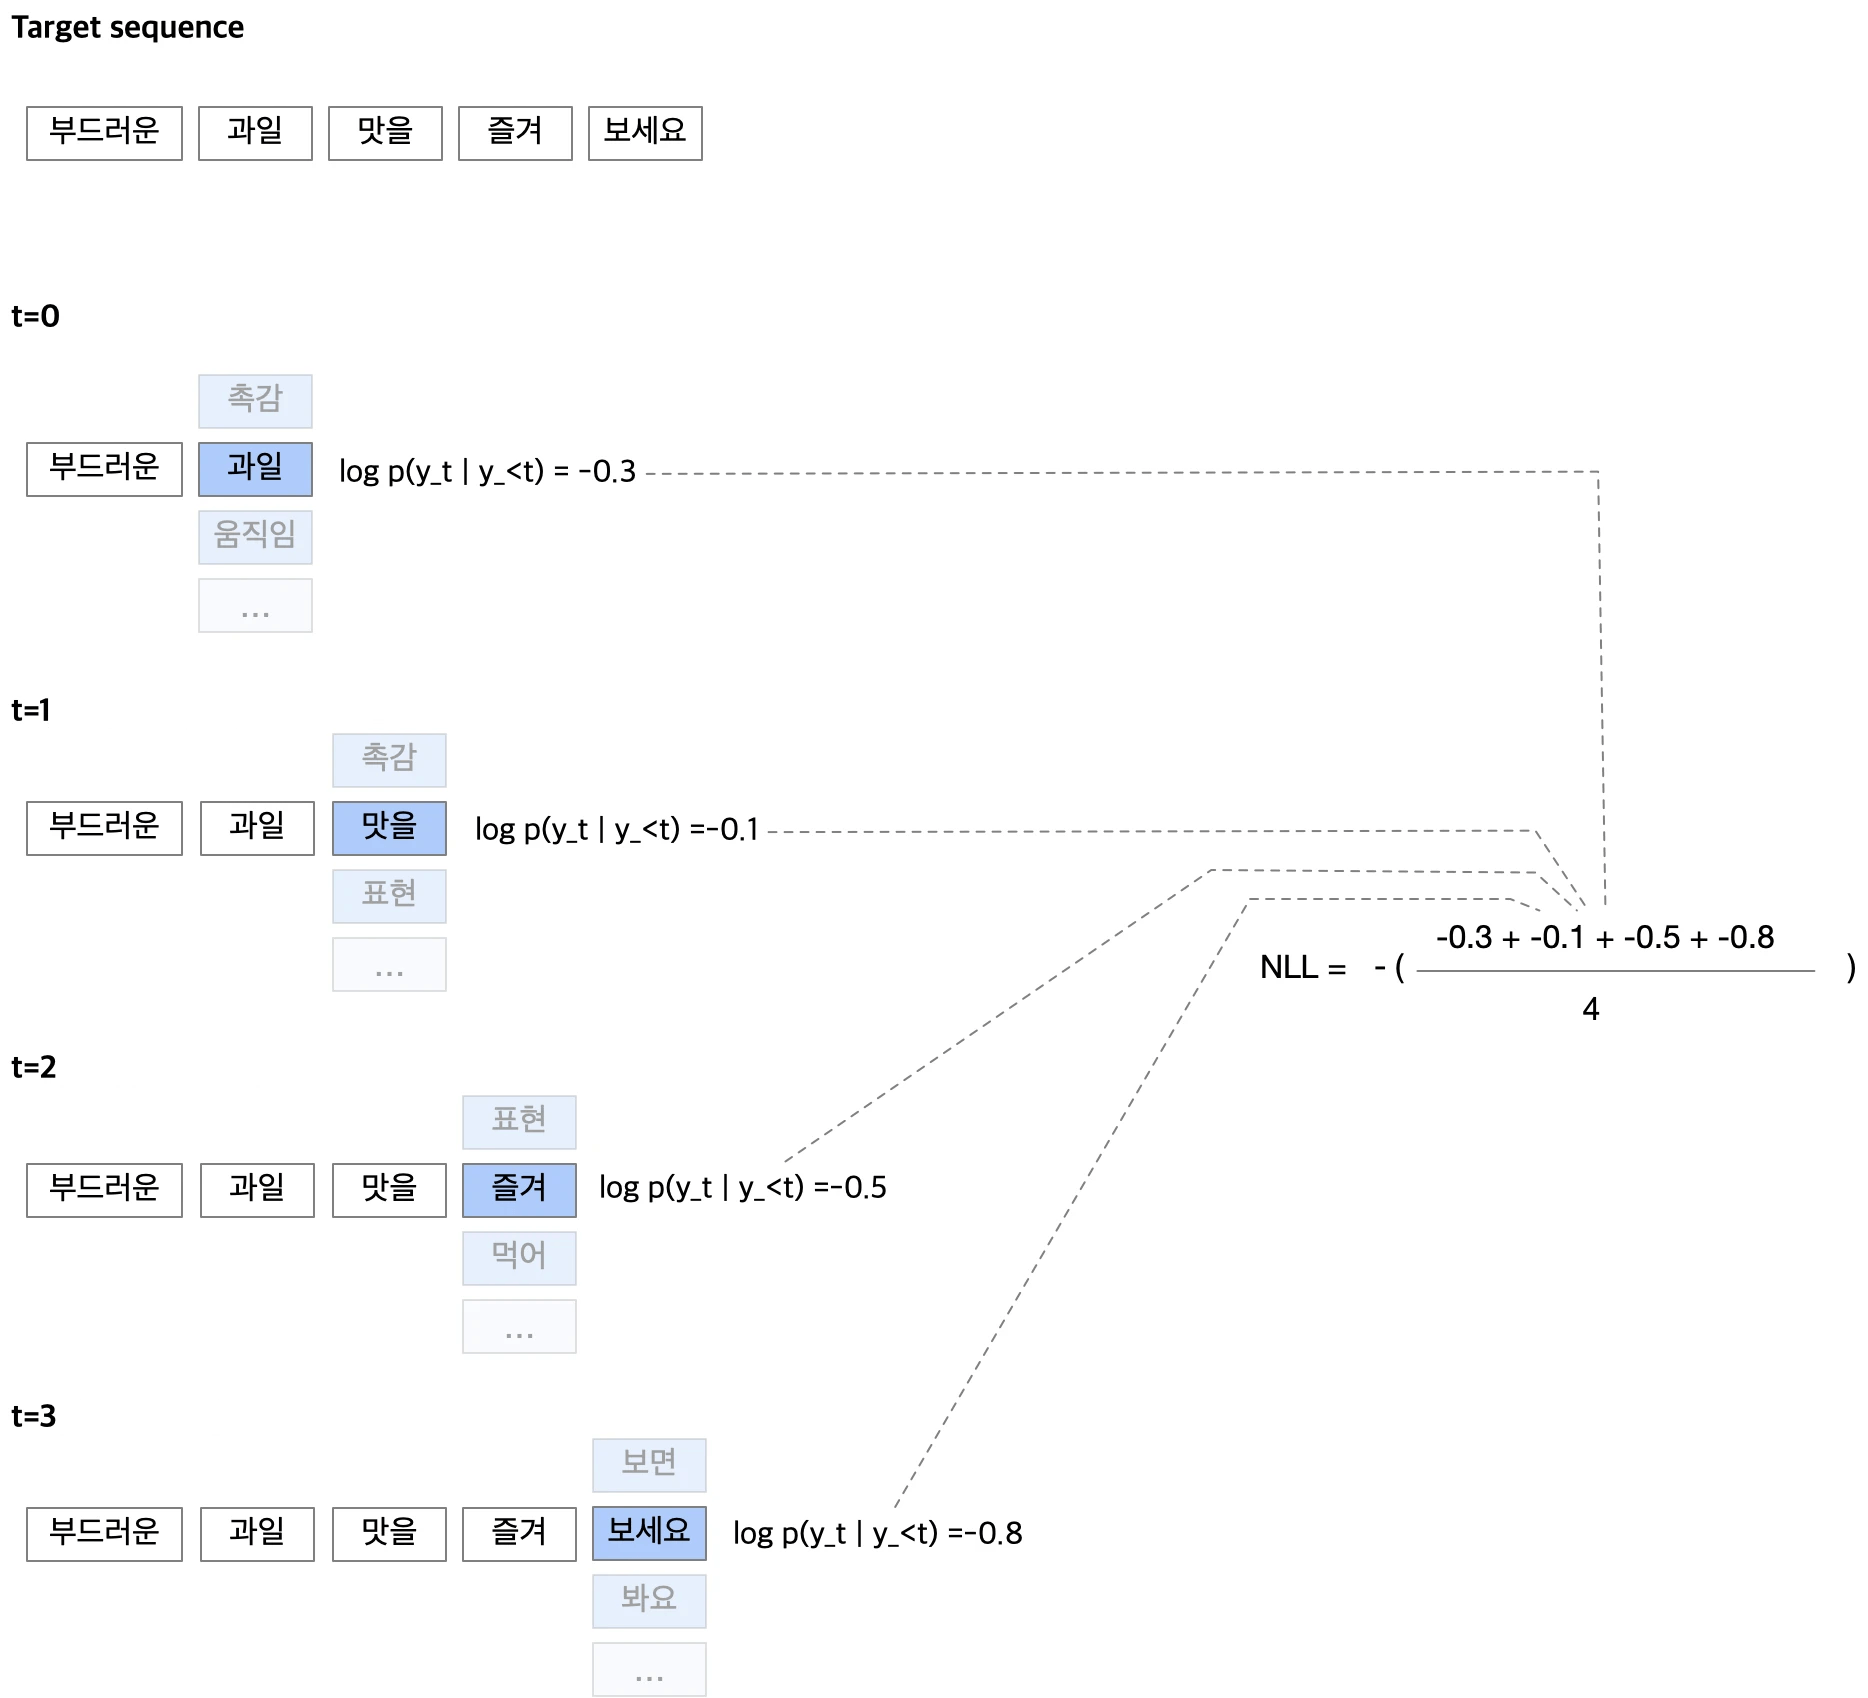
이 분리가 왜 필요한지는 앞서 본 뷰러 고무 사례가 잘 보여줍니다. "다양한 색상으로 연출해 보세요"는 자연스러움 기준으로는 훌륭하지만, 뷰러 고무라는 입력이 주어진 조건에서는 잘 설명되지 않아 문맥적합이 나빠집니다.
참고: NLL은 품질의 '정답'이 아니라 어디까지나 운용 프록시입니다. 낮은 NLL이 "무난하지만 공허한" 문구일 수도 있고, 짧은 문구는 점수 변동이 큽니다(Wang et al., 2022). 그래서 저희는 이 지표를 같은 입력에서 나온 후보들 사이의 상대 비교에만 사용했고, 사람 평가와의 정합성도 별도로 검증했습니다.
판정 모델(LLM Judge) 없이 선호 데이터 만들기
이 두 지표와 형식 검증기를 조합하면, 사람 라벨도 LLM Judge도 없이 학습용 선호 쌍(chosen/rejected pair)을 자동으로 만들 수 있습니다.
1. 각 입력마다 SFT 모델로 후보 출력 5개를 샘플링 생성
2. 각 후보에 형식 검증과 자연스러움(nll_nat)·문맥적합(nll_ctx) 계산 수행
3. 형식 통과 후보만 선호 데이터 풀에 포함
4. chosen은 문맥적합(nll_ctx)이 좋고 자연스러움(nll_nat)이 과도하게 나쁘지 않은 후보, rejected는 그 반대
   ※ 두 후보 간 NLL 격차(gap)가 충분히 크고, chosen이 최소 품질 기준(NLL 상한)을 만족하는 쌍만 채택
5. 입력당 가장 좋은 쌍만 남겨 학습 데이터로 사용
역할을 나누면 이렇습니다. 검증기는 출력이 UI에 들어갈 수 있는지를 판정합니다. 형식을 통과한 출력들 사이의 품질 순위는 NLL 지표가 매기고, 쌍 구성 규칙이 그 결과를 학습 데이터로 바꿉니다. 이 데이터가 학습에 직접 들어가는 만큼, 전 과정이 결정적이고 재현 가능하다는 점이 중요합니다.
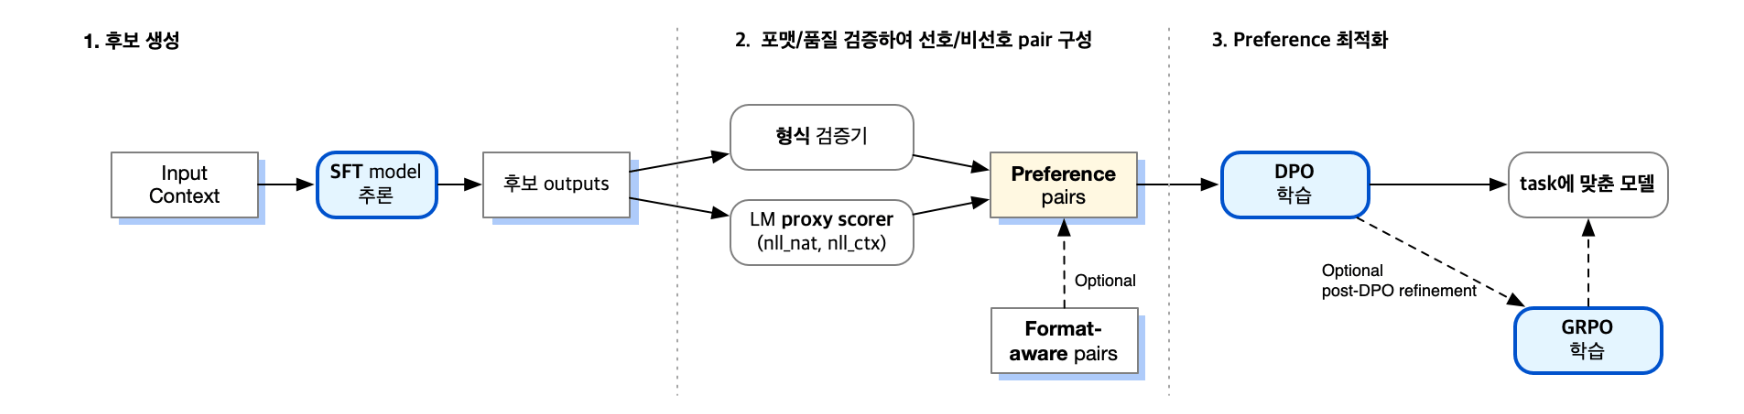
4. 정렬 학습: DPO, 그리고 형식 보정을 위한 GRPO
앞 섹션에서 만든 선호 쌍(chosen/rejected)은 그 자체로 DPO라는 학습 방법의 입력 형식입니다.
DPO (Direct Preference Optimization)
"같은 입력에서 이 출력이 저 출력보다 낫다"는 선호 쌍을 주면, chosen 출력의 생성 확률은 높이고 rejected 출력의 생성 확률은 낮추는 방향으로 모델을 직접 미세조정하는 방법입니다. RLHF(Reinforcement Learning from Human Feedback)처럼 별도의 보상 모델을 만들 필요가 없어 제한된 GPU 환경에서도 부담이 적습니다. (Rafailov et al., 2023)
DPO가 이 문제 설정에 적합하다고 판단한 근거는 학습 신호의 단위가 후보 쌍 사이의 상대 선호라는 점입니다. 앞서 본 것처럼 NLL의 절댓값은 짧은 문구에서 변동이 커 그대로 신뢰하기 어렵지만, 같은 입력에서 생성된 후보들 사이의 우열 관계는 비교적 안정적입니다. DPO는 이 상대 비교만을 학습 신호로 사용하므로, NLL 프록시의 절댓값 불안정성을 우회할 수 있습니다.
학습 조건
- 학습 데이터: 과제당 수천 쌍 규모의 선호 쌍
- 학습 방식: QLoRA 어댑터 학습(기저 모델을 4bit로 양자화한 채 LoRA 어댑터만 갱신하는 경량 미세조정, 자세한 내용은 지난 글 참고)
- 소요 시간: DPO 1회당 2~3시간, 여러 변형 실험을 부담 없이 반복할 수 있는 수준
DPO의 효과와 형식 통과율 하락
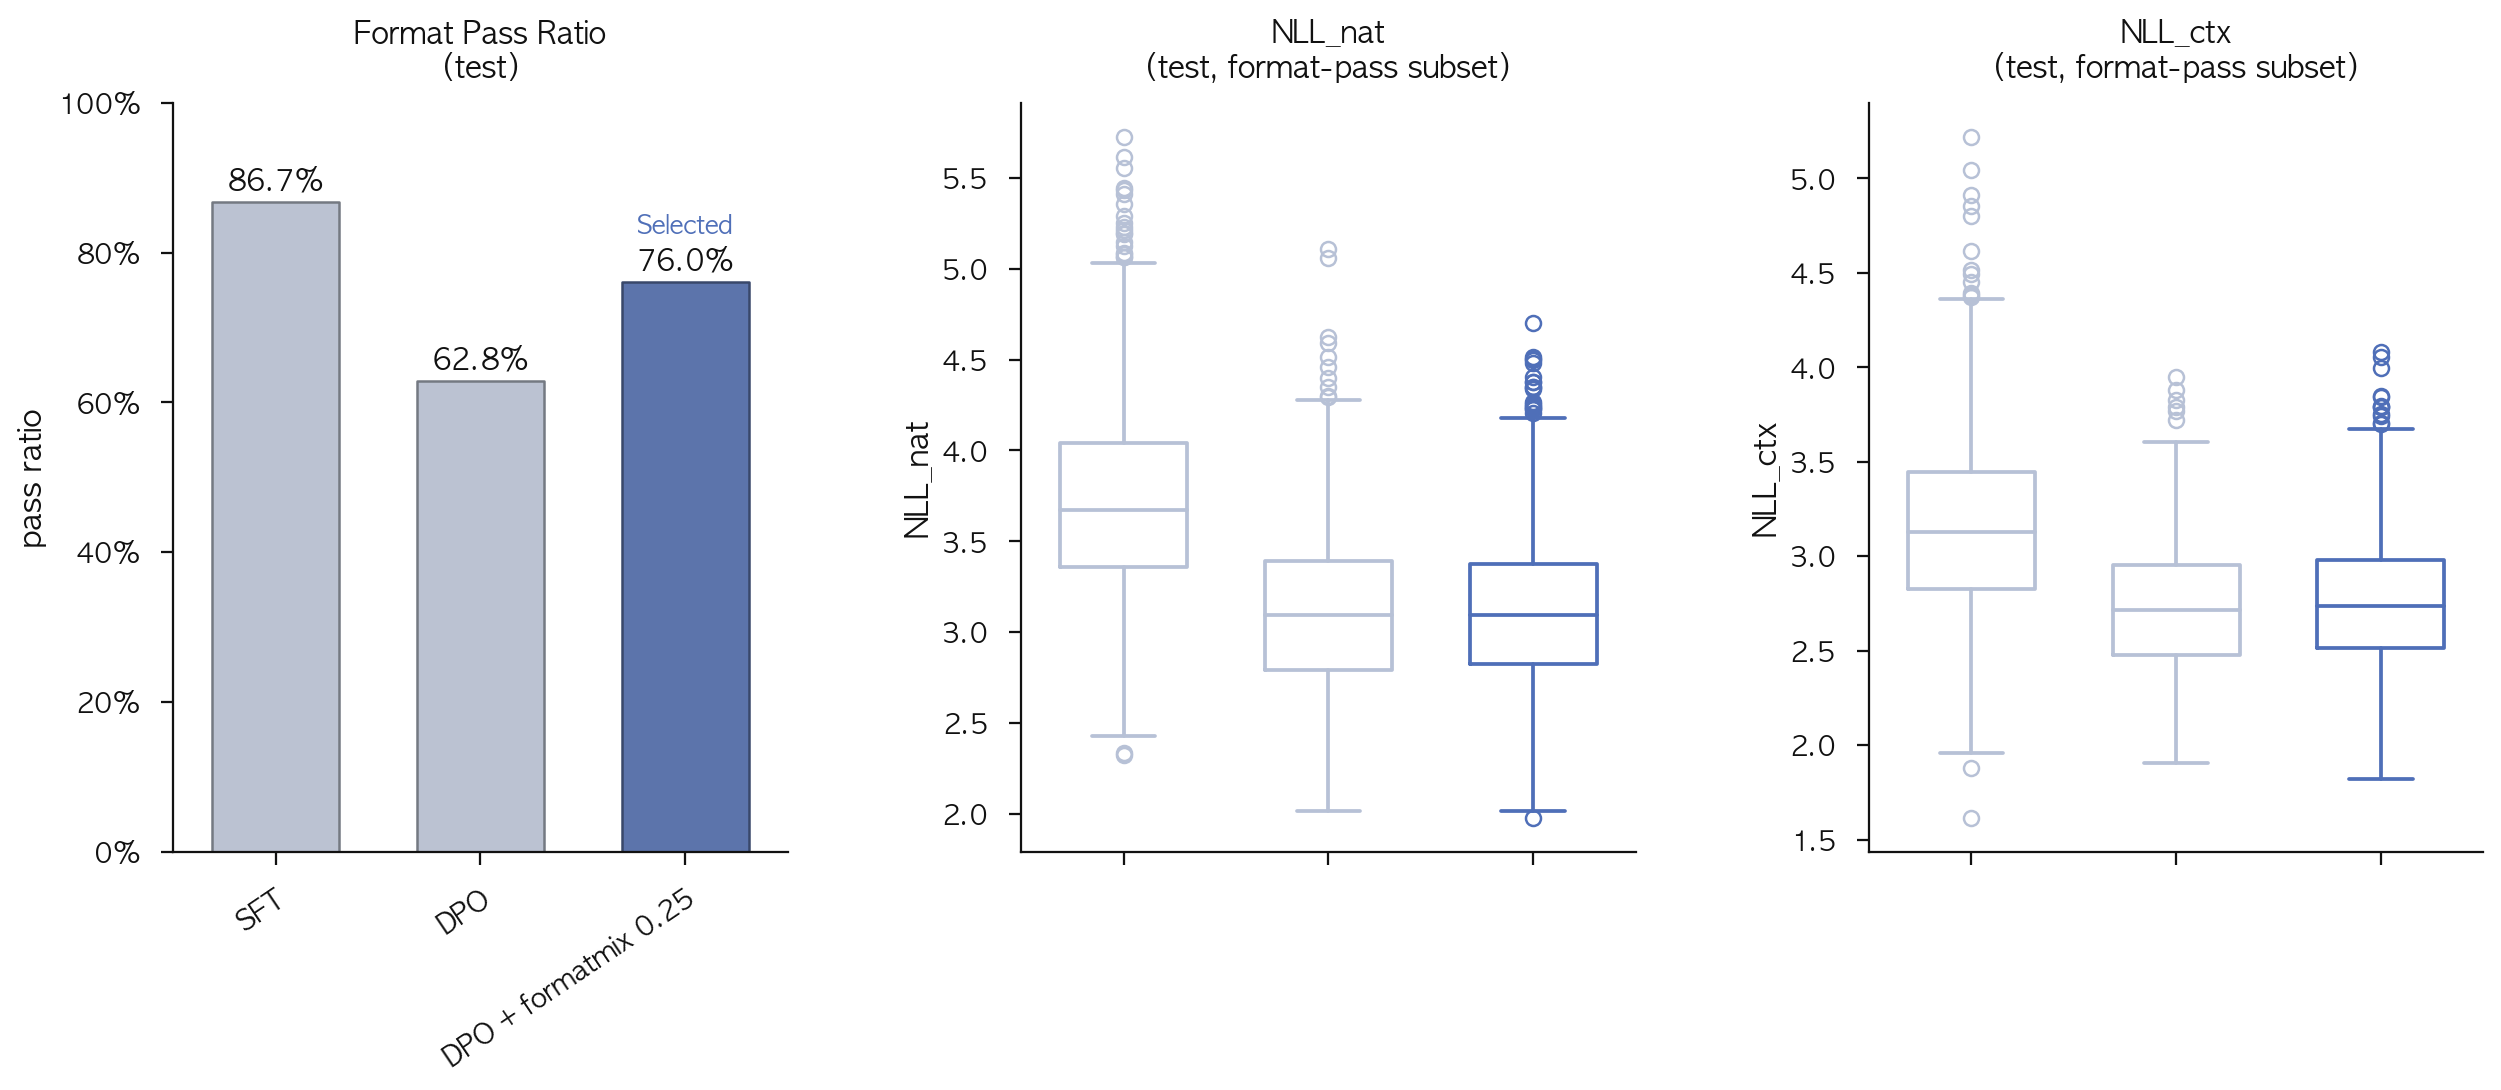
이렇게 만든 선호 쌍으로 DPO를 학습한 결과, 의도한 효과가 나타났습니다. 형식을 통과한 출력들의 NLL 중앙값이 SFT 대비 뚜렷하게 낮아졌습니다(WHO 카드 기준 자연스러움 프록시 nll_nat 3.672 → 3.096). 다만 예상하지 못한 부작용이 함께 나타났습니다.
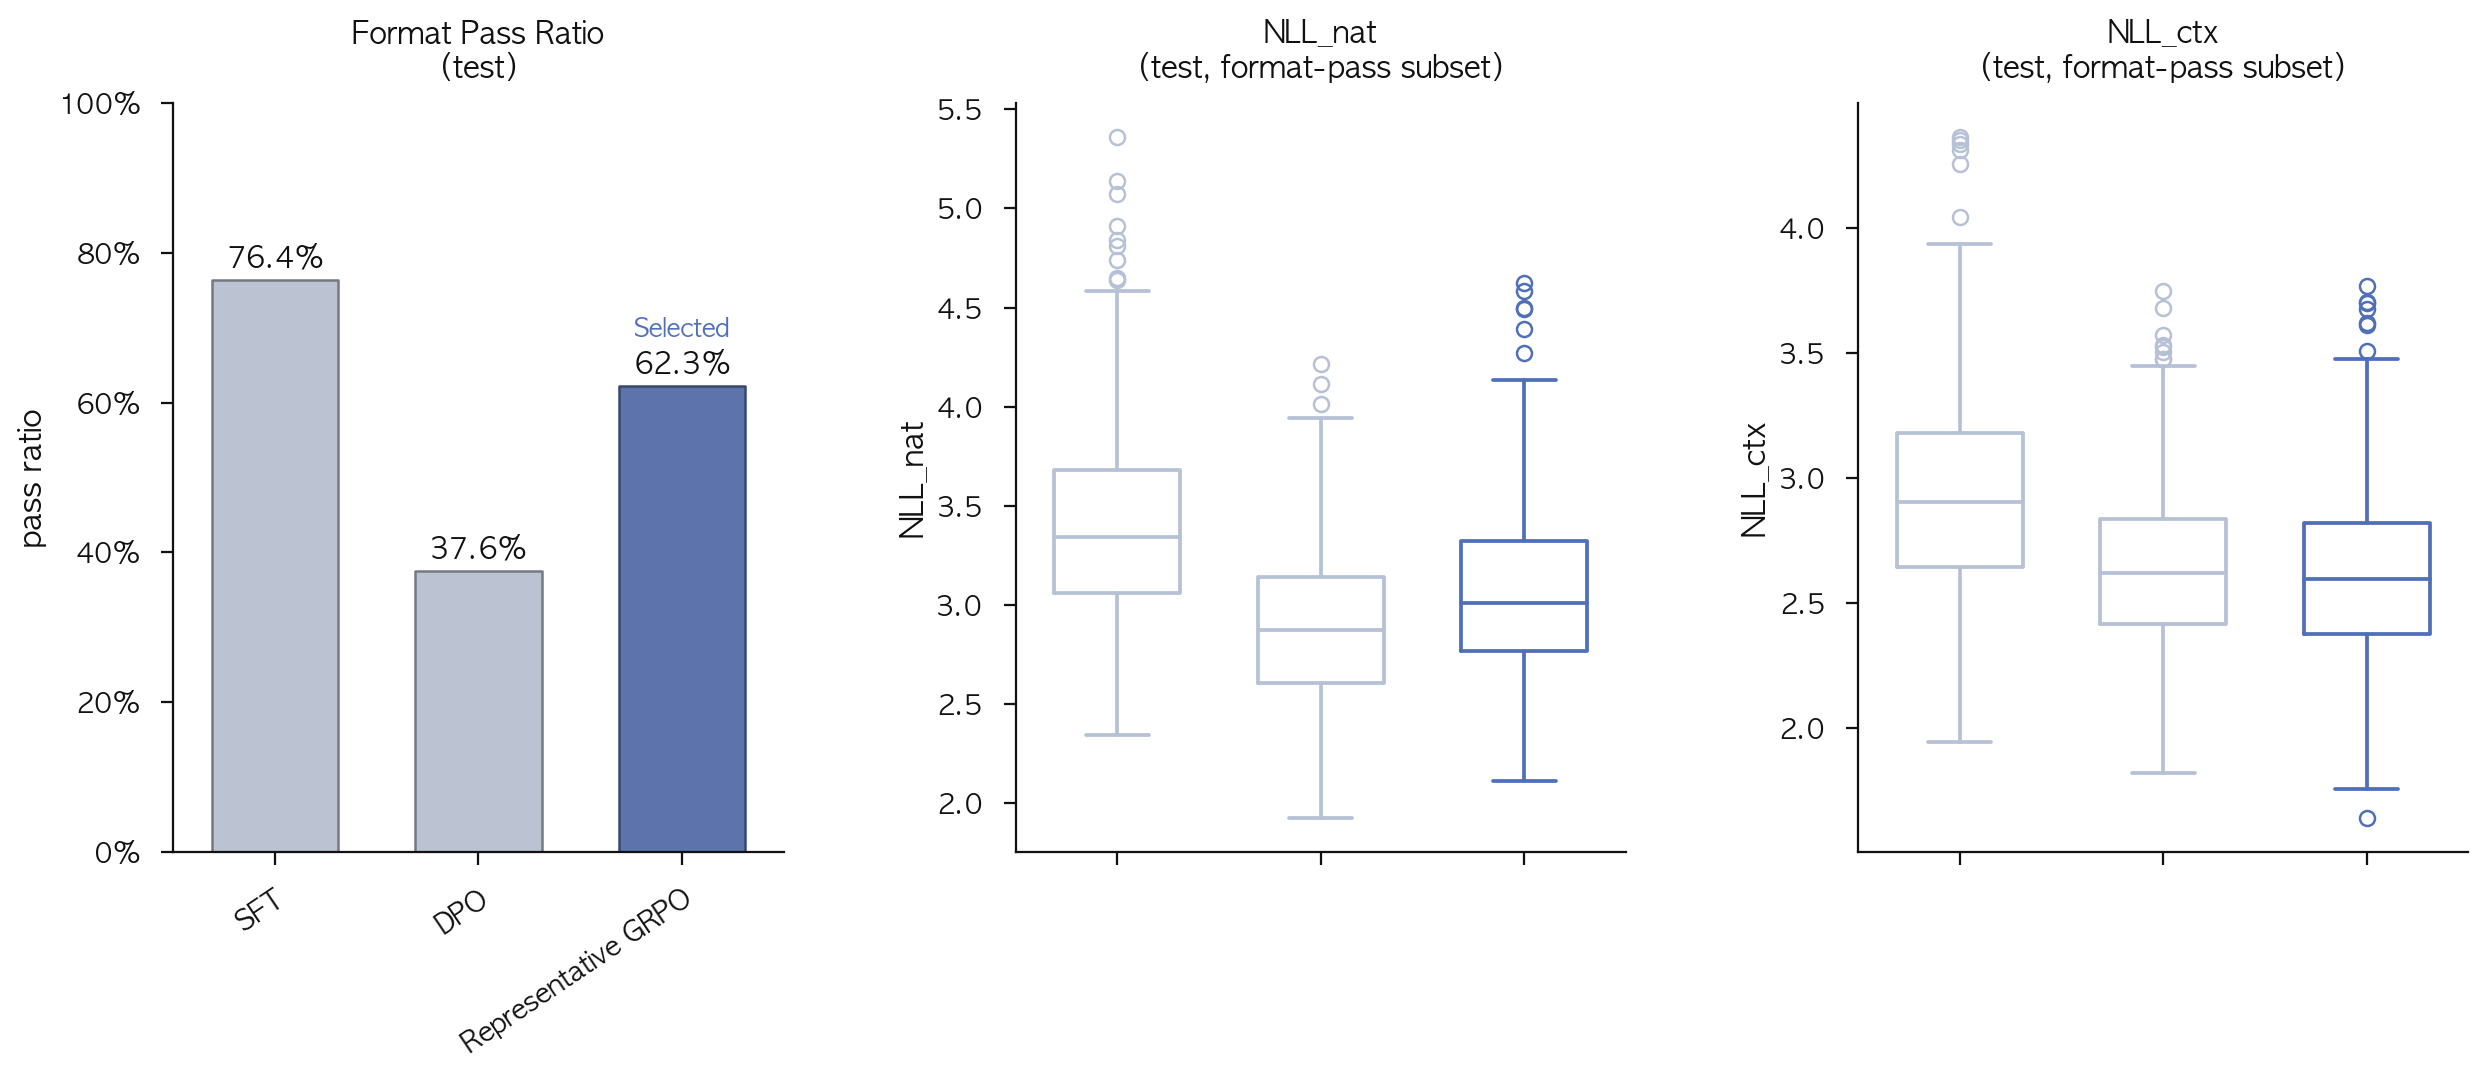
SFT에서 잘 지켜졌던 형식 통과율이 크게 하락했습니다. WHO 카드에서 SFT의 형식 통과율 86.7%가 DPO 이후 62.8%로 떨어졌고, 제약이 더 촘촘한 TPO 카드에서는 76.4%에서 37.6%까지 하락했습니다.
선호 쌍을 형식 통과 후보들로만 구성했기 때문에, DPO는 '형식을 지키는 것'과 '어기는 것'의 차이를 본 적이 없습니다. 자연스러움을 높이는 최적화가 SFT로 익혀 둔 형식 경계까지 제약 없이 넘어섰습니다. 형식과 품질이 같은 방향으로 움직이지 않는 절충(trade-off) 관계라는 것이 실험적으로 확인됐습니다. 이 충돌을 완화하기 위해 과제별로 두 가지 제어 수단을 적용했습니다.
방법 1. 형식 인지 선호 쌍 증강 (formatmix) - WHO 카드
WHO 카드에는 데이터 수준의 방법이 동작했습니다. 형식을 의도적으로 무너뜨린 출력을 rejected 쪽에만 배치한 합성 선호 쌍을 DPO 학습 데이터에 일정 비율 섞는 방식입니다(이하 formatmix). 합성 오답은 오픈소스 대형 모델(GPT-OSS-120B)로 생성했는데, 여기서 관건은 오답을 과도하게 망가뜨리지 않고 정답에 가깝지만 규칙 하나를 어긴 수준(near-miss)으로 만드는 것이었습니다. 누가 봐도 틀린 쉬운 실패만 넣으면 학습은 되지만 일반화가 약해지고, 문장 길이나 표현이 과하게 위축될 수 있기 때문입니다. 혼합 비율을 여러 값으로 바꿔가며 실험한 결과는 아래와 같고, 운영에 쓸 절충 지점을 여기서 골랐습니다.
비율 0.50은 형식을 가장 많이 회복하지만 NLL이 다시 나빠집니다. 채택한 0.25는 DPO가 도달한 자연스러움(nll_nat)을 그대로 유지하고 문맥적합(nll_ctx)도 거의 보존하면서(+0.023), 형식 통과율을 13.2%p 회복하는 절충점이었습니다. 실패 유형 분포에서도 DPO에서 53.4%까지 집중됐던 'subtitle 길이 초과'가 35.1%로 완화됐습니다.
방법 2. 형식 보상 기반 GRPO 보정 - TPO 카드
TPO 카드에서는 formatmix 계열 변형의 비율과 오류 유형 구성을 바꿔가며 여러 번 시도했지만 모두 DPO 기준선의 형식 통과율조차 넘지 못했고, 오류 예시를 더 공격적으로 주입한 구성은 오히려 새로운 실패 양상을 만들며 통과율이 더 떨어졌습니다. 그래서 TPO에는 접근을 바꿔, NLL 품질은 DPO로 먼저 확보하고, 그 위에 형식만을 보상으로 최적화하는 GRPO 보정 단계를 분리해 추가했습니다.
GRPO (Group Relative Policy Optimization)
하나의 입력에서 모델이 여러 출력을 생성하고, 그룹 내 상대적 보상 차이로 정책을 업데이트하는 강화학습 기법입니다. 별도의 가치 모델(critic) 없이 동작해 제한된 GPU 환경에서도 부담이 적고, 저희가 원하는 품질 기준을 보상 함수로 직접 정의할 수 있습니다. (Shao et al., 2024)
보상은 단순한 통과/실패 이진값이 아니라 완전한 형식 통과(+), JSON 파싱 실패(큰 감점), 필드별 위반 유형(길이 초과·어미 위반·슬롯 범주 오류 등 유형별 차등 감점)을 구분해, 위반 정도에 따라 점수가 달라지는 형태(shaped reward)로 설계했습니다. GRPO를 선택한 근거는 학습 방식에 있습니다. DPO는 미리 구축해 둔 선호 쌍으로 학습하는 off-policy 방법인 반면, GRPO는 학습 중인 모델이 그 시점에 생성하는 출력을 그대로 학습 신호로 쓰는 on-policy 방법이라, 현재 모델의 행동을 직접 교정하기에 효과적입니다.
GRPO 보정은 DPO 대비 형식 통과율을 24.7%p 회복시키면서, 문맥적합 프록시(nll_ctx)는 오히려 소폭 개선하고 자연스러움 프록시(nll_nat)의 악화 폭은 +0.140 수준으로 제한했습니다. 실패 유형의 분포도 달라졌는데, DPO에서 61.1%까지 집중됐던 'reason 길이 초과'가 크게 줄고 남은 실패는 'title 어미 위반'(50.3%) 중심으로 재편됐습니다. 검증 단계에는 형식 통과율이 더 높은 GRPO 변형(82.4%)도 있었지만, 자연스러움 손실이 더 컸기 때문에(검증 기준 nll_nat 2.885 vs 2.811) 품질 보존 관점에서 보수적인 변형을 대표로 선택했습니다.
TPO에서 DPO만으로 안 됐던 이유
두 과제의 결과가 이렇게 갈린 이유를 저희는 네 가지로 정리했습니다.
(1) 형식 통과 확률은 조건 수에 민감
(2) DPO는 오프라인 선호 학습(off-policy)이라 실패 유형을 미리 다 덮기 어려움
(3) On-policy인 GRPO는 실제 실패를 직접 교정
(4) 단계 분리가 목적 간 간섭을 완화
5. 형식과 품질의 절충
홀드아웃 테스트(학습·검증과 상품 단위로 겹치지 않게 분리한 천 개 규모의 프롬프트)에서 두 과제의 대표 구성을 다시 확인했습니다. 개별 수치는 앞에서 본 그대로이므로, 여기서는 표의 중앙값만으로는 보이지 않는 형식 통과 출력 전체의 NLL 분포를 보겠습니다. 두 과제 모두 정렬 학습 후 박스플롯의 상자가 통째로 아래로 내려왔습니다. 중앙값만이 아니라 분포 자체가 개선된 것입니다.
정리하면 세 가지입니다.
- 품질과 형식은 절충 관계: 정렬 학습은 자연스러움·문맥적합 프록시를 크게 개선했지만 그 대가로 형식 통과율이 하락할 수 있고, 구조 제약이 강할수록 하락 폭이 컸습니다.
- 형식 제어 수단은 과제마다 다름: WHO에서는 데이터 수준 증강(formatmix)으로 충분했지만, 더 복잡한 문제의 TPO에서는 보상 기반 후속 보정(GRPO)이 필요했습니다.
- 형식 통과율만큼은 여전히 SFT가 우위: 정렬 학습 후에도 SFT에 미치지 못합니다(TPO 기준 62.3% vs 76.4%). 다만 형식 실패는 추론 시점에 복구할 수 있는 종류의 실패인 반면 품질은 그렇지 않다는 점이, 이 절충을 감수한 근거였습니다.
아래 예시에서 보듯, 어느 상품에나 통용되는 범용적인 문구 대신 속눈썹 손상 방지, 실리콘 고무라는 상품의 실제 속성이 문구에 반영되고, 장소 슬롯도 '집'으로 구체화됩니다. reason → title → subtitle의 연결도 하나의 이야기로 매끄럽게 이어집니다.
6. 사람 평가와 NLL 프록시 간의 정합성 검증
선호 쌍을 만든 신호도 NLL이고 평가 지표도 NLL이니, 자칫 "NLL로 학습해서 NLL이 좋아졌다"는 순환 논리가 될 수 있습니다. 이 우려를 확인하기 위해 형식 검증을 통과한 출력 약 2,000건을 대상으로 블라인드 사람 평가(0/1/2점 척도)를 수행하고, 같은 샘플에서 NLL 점수와 상용 LLM 판정 모델들의 점수를 사람 점수와 각각 비교했습니다.
두 과제 × 두 평가축(자연스러움/문맥적합), 총 4개 평가 셀을 단순 평균한 기준으로, 1.3B 규모의 작은 외부 평가 모델이 계산한 NLL이 대형 판정 모델들과 대등하거나 더 나은 수준으로 사람 평가와 정합했습니다.
순위 정합성(Kendall tau-b)은 Gemini 2.5 Flash와 신뢰구간이 겹치는 사실상 동급 수준이었고, 우위가 뚜렷했던 쪽은 명확한 실패와 성공을 가르는 분리력(AUROC)이었습니다. 대표 비교쌍(formatmix 0.25 vs. SFT)의 출력을 나란히 놓고 고르게 한 2인 블라인드 평가에서도 자연스러움 축에서 정렬 학습 모델이 67.4%(동점 제외), 문맥적합 축에서 60.9%로 더 자주 선호되었습니다.
물론 이 결과가 "NLL이 판정 모델을 항상 이긴다"는 뜻은 아닙니다. 일부 자연스러움 평가 셀에서는 Gemini가 더 높은 순위 정합성을 보였고, 문맥적합 축은 평가자 간 일치도 자체가 낮아 해석에 주의가 필요했습니다. 따라서 결론은 일반화하지 않고 이 과제 범위로 한정해 내립니다. 짧은 한국어 UI 문구라는 조건에서, NLL은 판정 모델 없이도 선호 쌍을 자동 구성하기에 충분한 방향성을 가진, 재현 가능하고 저렴한 프록시로 작동했습니다.
7. 정렬 학습의 세 가지 발견
DPO냐 GRPO냐보다, 어떤 학습 신호를 공급하느냐가 중요하다
이번 프로젝트에서 결과를 가장 크게 바꾼 변수는 학습 데이터와 보상에 담기는 신호의 설계였습니다. 선호 쌍의 gap 조건과 최소 품질 기준, formatmix 혼합 비율, 합성 오답을 얼마나 정답에 가깝게 둘지, GRPO 보상의 세부 형태까지 구성 요소 하나하나가 형식-품질 절충점을 크게 움직였습니다.
이를 단적으로 보여준 실패 사례가 있습니다. 형식을 더 잘 가르치려고 rejected 쪽에 오류 예시를 대량으로 섞었더니, 형식 통과율이 오히려 DPO 기준선보다 떨어졌습니다. 모델이 실제로 범하지 않을 유형의 오류가 섞이면 '피해야 할 경계'를 잘못 배우기 때문입니다. 모델이 실제로 범할 법한 near-miss 오류만 적정 비율로 넣었을 때에만 효과가 있었습니다.
추론 시점 제어는 정렬 학습을 대체하지 못한다
후보를 여러 개 생성해 형식을 통과하는 것만 골라 쓰는 추론 시점 제어도 합리적인 대안입니다. 실험해 보면 재시도(retry@5)만으로 형식 통과율을 98% 이상으로 끌어올릴 수 있습니다. 하지만 NLL 재순위화(rerank@5)까지 적용해도 형식 통과 출력의 품질 프록시는 학습 기반 정렬 모델보다 자연스러움·문맥적합 중앙값이 모두 +0.6~0.8만큼 나빴고, 추론 비용은 후보 5개를 생성·재순위화하는 연산 기준 약 5배였습니다.
형식 검증 필터는 추론 시점에도 가능하지만, 품질을 모델에 내재화하는 것은 학습으로만 가능했습니다. 그럼에도 정렬 학습을 거친 모델도 통과율이 100%는 아니므로, 운영에서는 정렬 학습으로 기본 품질과 수율을 끌어올리되 남은 형식 실패에만 검증기 기반 재시도를 적용하는 하이브리드 구성이 비용과 품질의 균형점이었습니다.
재현 가능한 LLM 평가 체계가 곧 자산이 된다
이번에 만든 형식 검증기 + NLL 품질 평가 체계는 이 프로젝트 안에서만도 세 가지 역할을 했습니다. 선호 쌍을 자동 구성하는 학습 데이터 도구였고, formatmix 비율 스윕과 GRPO 변형 선택에서 실험 구성을 같은 기준으로 비교하는 척도였으며, 홀드아웃 테스트에서는 최종 평가 지표였습니다.
이런 재사용이 가능한 것은 평가가 사람 개입 없이 결정적으로 동작하고 실행 비용이 낮기 때문입니다. 같은 이유로 이 체계는 모델 버전 간 품질 비교나 배포 전 검증처럼 앞으로의 판단에도 그대로 쓸 수 있는 공통 자산이 됩니다. 품질 기준이 재현 가능한 숫자로 존재하면 모델 버전을 비교하는 판단이 빨라지고, 개선 주기도 함께 짧아집니다.
8. 마무리하며
이번 글은 직접 구축한 sLLM을 화면에 바로 노출되는 품질 기준에 맞추는 과정과, 이를 뒷받침한 평가 체계를 다뤘습니다.
- 프롬프팅으로도 SFT로도 잡히지 않던 형식·자연스러움·문맥적합의 동시 만족을, 형식 검증기와 두 개의 NLL 지표로 판정할 수 있는 문제로 바꿨습니다.
- 이 지표로 선호 데이터를 사람 라벨 없이 자동 구성해 DPO를 학습했고, 그 대가로 떨어진 형식 통과율은 과제에 따라 formatmix와 GRPO 보정으로 되돌렸습니다.
- 블라인드 사람 평가와 대조해, NLL이 순환 논리에 그치지 않고 품질 신호로 작동함을 확인했습니다.
제목 그대로 측정할 수 있게 되자 개선할 수 있었습니다. 모델은 생성한 뒤 걸러내는 대신, 처음부터 상품에 맞는 문구를 내놓는 쪽으로 옮겨 갔습니다. 물론 여전히 남은 과제도 있습니다. TPO 카드의 상황 정보(계절·시간·장소)를 문구에 더 풍부하게 반영하는 일, 외부 평가 모델을 교체했을 때의 민감도 검증이 대표적입니다. 이 과제들을 풀어가며 올리브영의 도메인 특화 AI를 계속 고도화해 나가겠습니다.
그럼 저는 다음 글에서 또 새로운 이야기로 돌아오겠습니다. 읽어주셔서 감사합니다! 🙇